AI Gateway · AI Studio
Tous les modèles.Une seule API.
Connectez, sécurisez et gouvernez tous vos LLM derrière une seule API compatible OpenAI. Avec AI Studio, vos équipes obtiennent une clé, choisissent un modèle, chattent et suivent leur consommation et leurs dépenses, pendant que vous gardez la main sur le routage, les guardrails et les budgets.
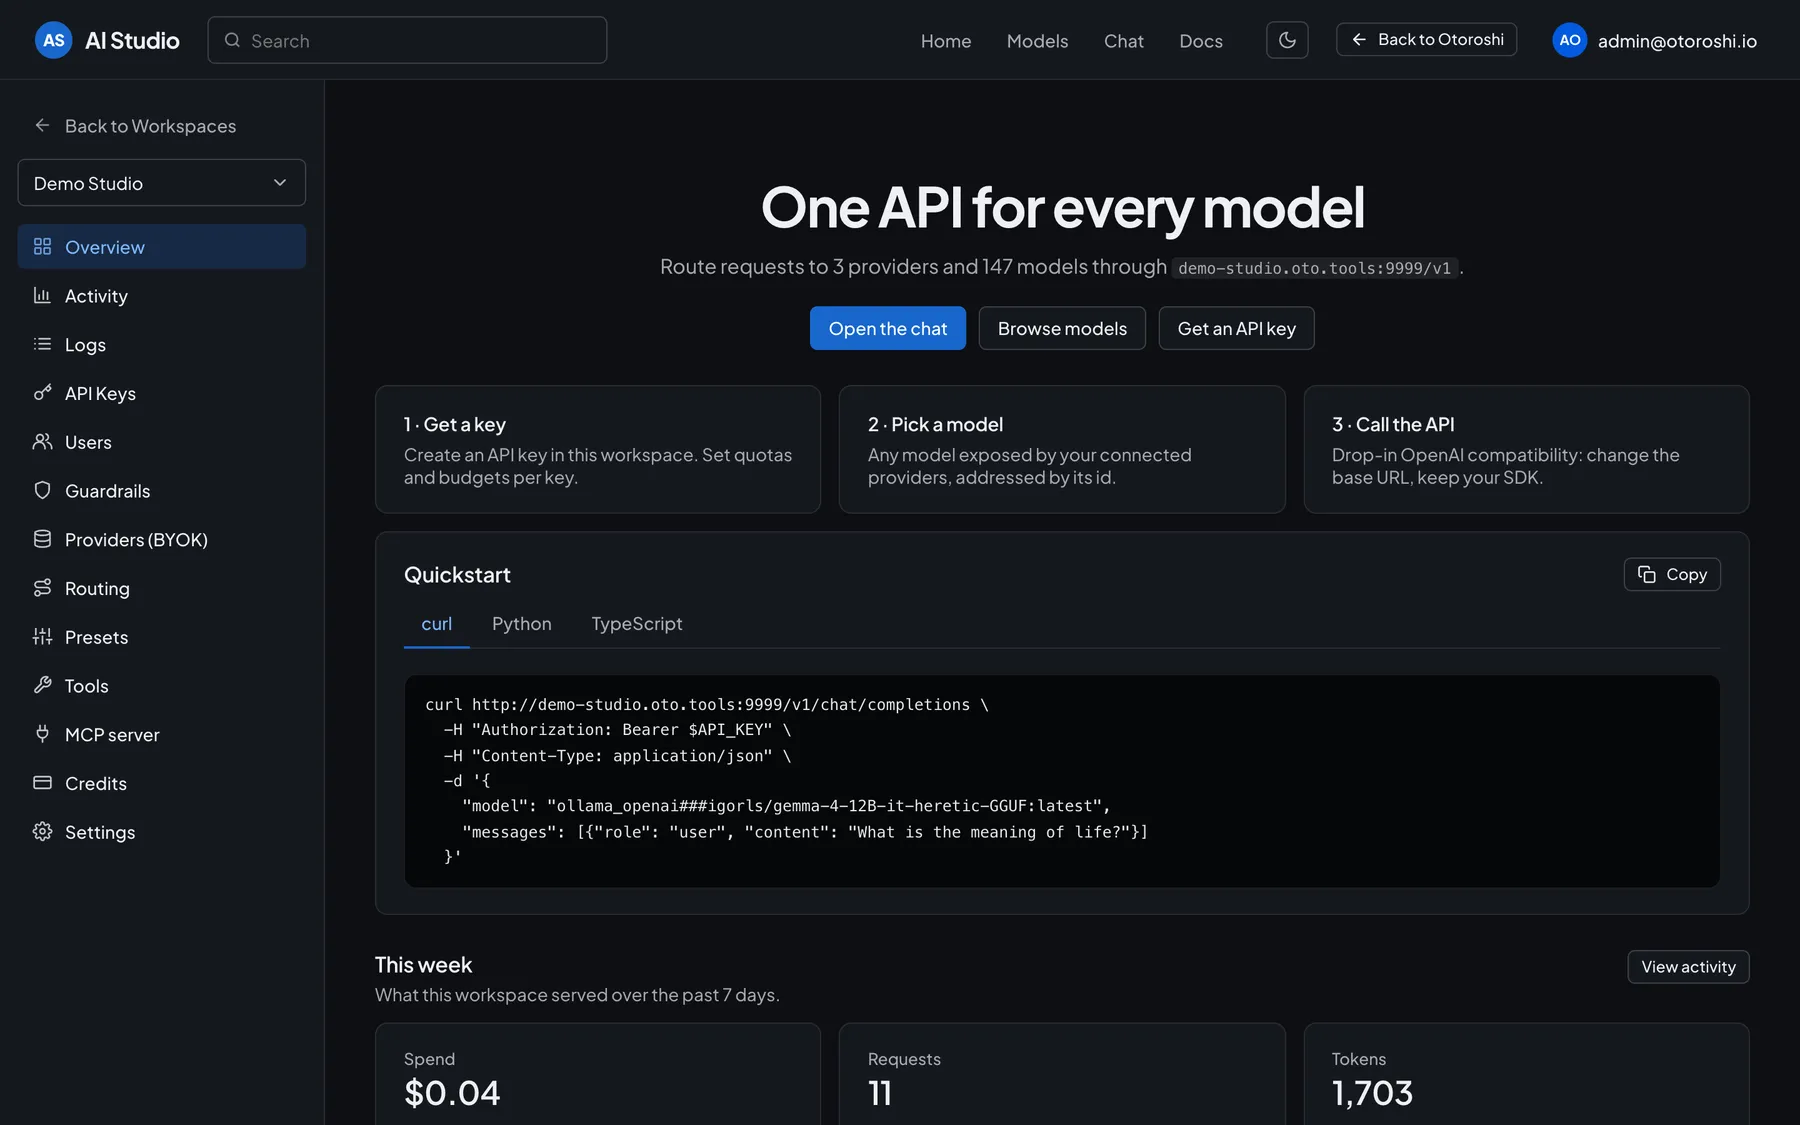
Une URL de base par workspace
Chaque workspace d’AI Studio a sa propre URL de base compatible OpenAI, ses clés d’API, ses fournisseurs et ses politiques. Changez l’URL de base, gardez votre SDK.
50+ fournisseurs, vos propres clés
OpenAI, Anthropic, Mistral, Gemini, Azure, Groq, DeepSeek, Scaleway, OVHcloud, Cohere, Hugging Face, Ollama… connectés avec vos propres clés de fournisseur.
Routage & fallbacks
Des chaînes de repli quand un fournisseur échoue, de la répartition de charge entre fournisseurs, et un routage intelligent qui choisit le bon modèle pour chaque prompt.
Guardrails
Modèles autorisés et bloqués, politiques de contenu sur les prompts et les réponses, appliqués par la gateway à chaque clé d’un workspace.
Budgets & quotas
Des plafonds de dépenses par clé d’API ou pour tout un workspace, chacun sur sa propre fenêtre, et des quotas par clé.
Consommation & dépenses en direct
Dépenses, requêtes, tokens, taux de cache et latence, par clé, par utilisateur et par modèle, avec tendances et export CSV.
Une API pour plus de 50 fournisseurs — cloud, souverains ou locaux
- OpenAI
- Anthropic
- Mistral AI
- Gemini
- Ollama
- Azure AI
- Groq
- DeepSeek
- Scaleway
- OVHcloud
- Cohere
- Hugging Face
- Cloudflare AI
- ElevenLabs
- + beaucoup d’autres, modèles locaux inclus
AI Studio · Démarrer
Une clé, un modèle, un appel.
C’est tout.
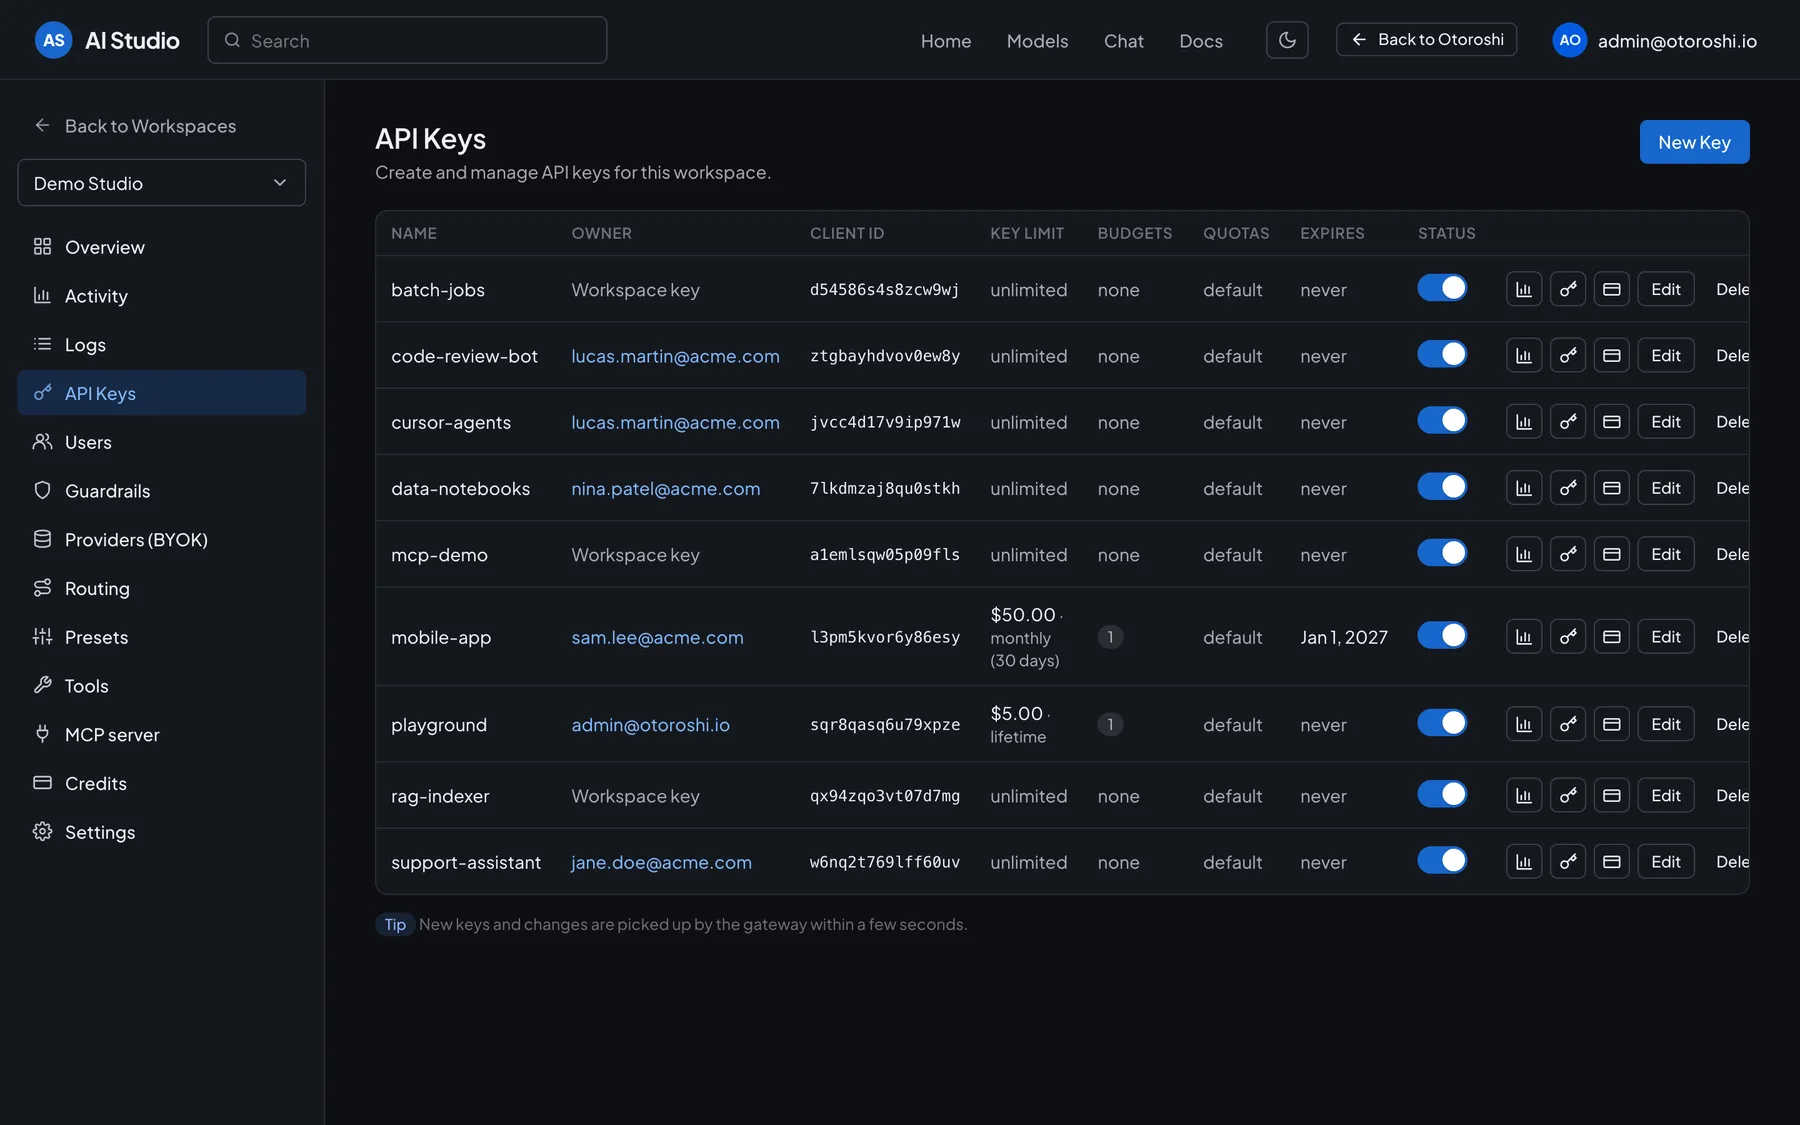
Créez une clé d’API dans un workspace et réglez ses quotas et ses budgets. Choisissez n’importe quel modèle exposé par vos fournisseurs connectés, désigné par son identifiant. Appelez l’API compatible OpenAI du workspace : changez l’URL de base, gardez votre SDK. Chaque clé a un propriétaire, une limite, des budgets et une date d’expiration.
- Des clés d’API avec un propriétaire
- Tous les modèles de vos fournisseurs
- Compatibilité OpenAI immédiate
- Limites, budgets, expiration
AI Studio · Activité
Suivez et optimisez
chaque euro dépensé en LLM.
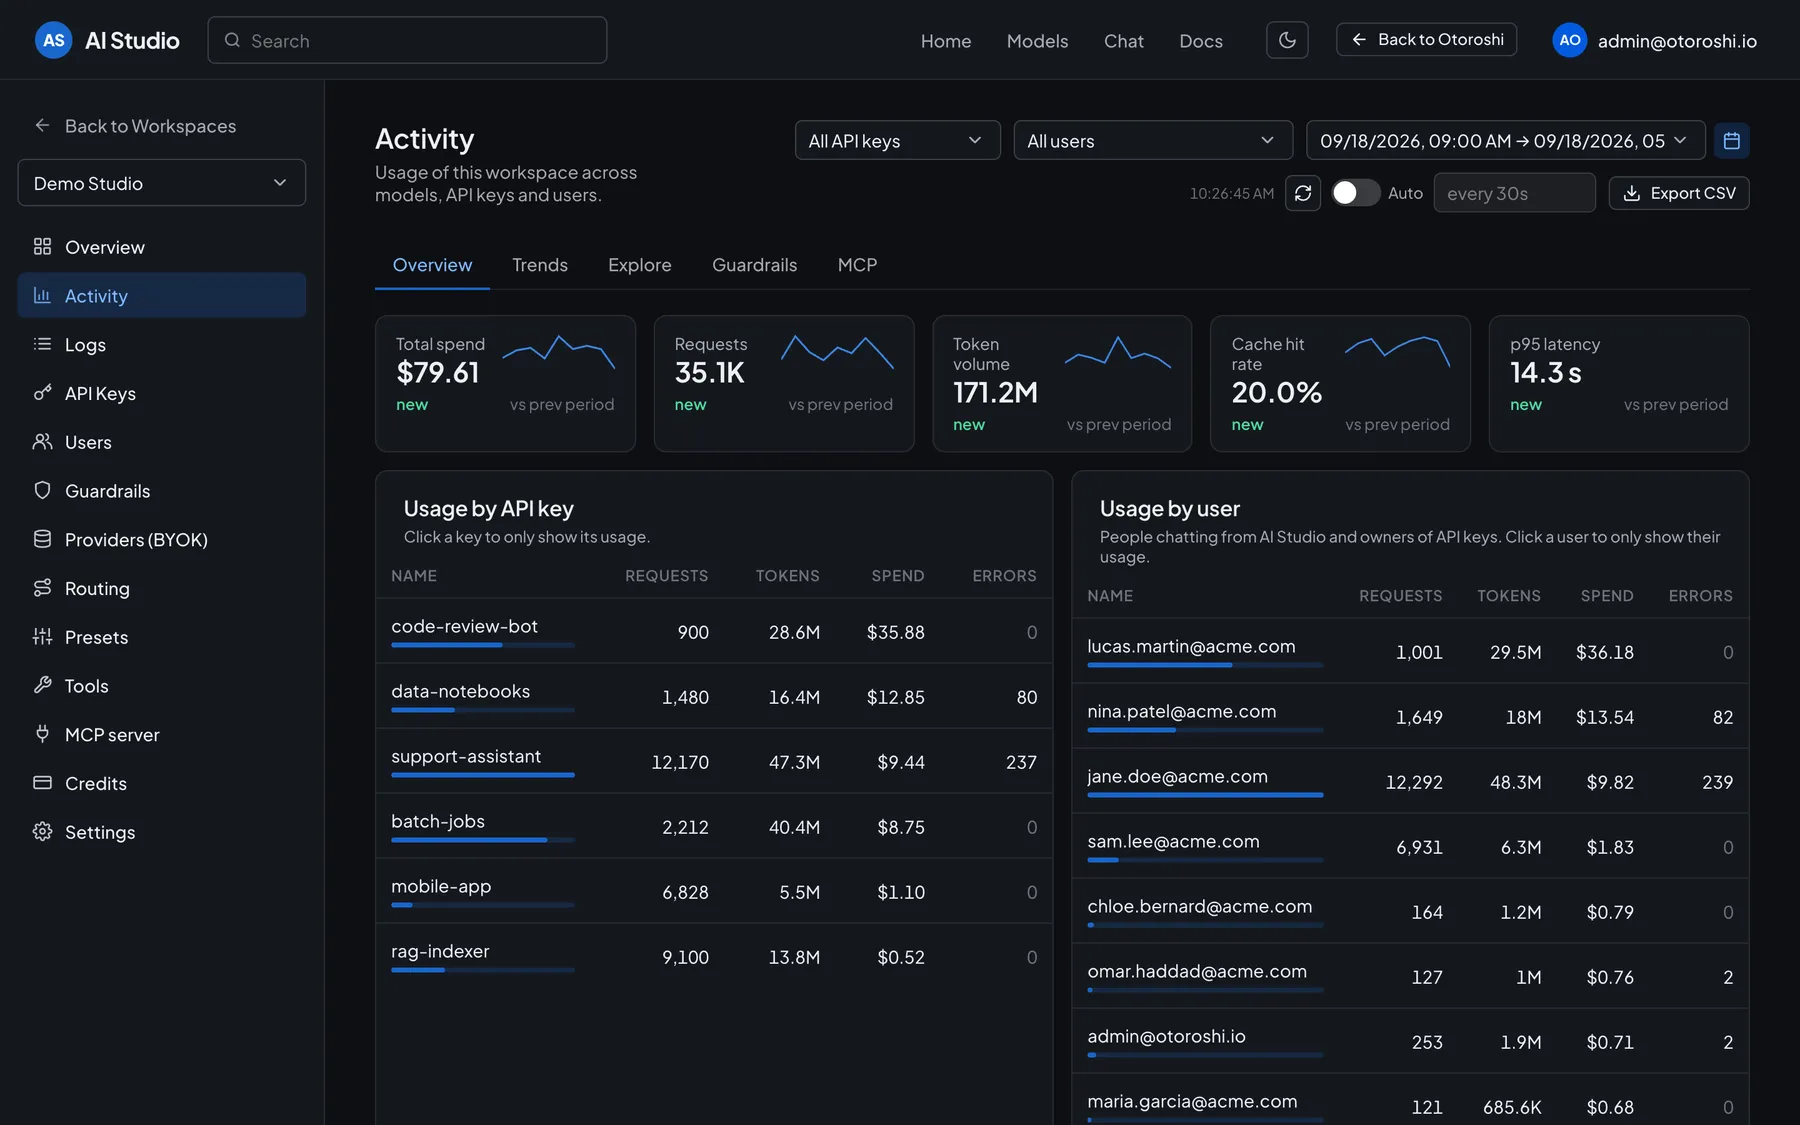
La page Activity d’AI Studio montre ce que chaque workspace dépense, et pourquoi : dépenses, requêtes, volume de tokens, taux de cache et latence, puis la consommation de chaque clé d’API, de chaque utilisateur et de chaque modèle, avec les tendances dans le temps et un export CSV. Le suivi des coûts est activé par défaut, et les budgets appliqués par la gateway arrêtent la dépense là où vous l’avez décidé.
- Dépenses par clé, utilisateur et modèle
- Budgets appliqués par la gateway
- Taux de cache & latence
- Export CSV
AI Studio · Routage & guardrails
Décidez quel modèle répond.
Et ce qu’il peut dire.
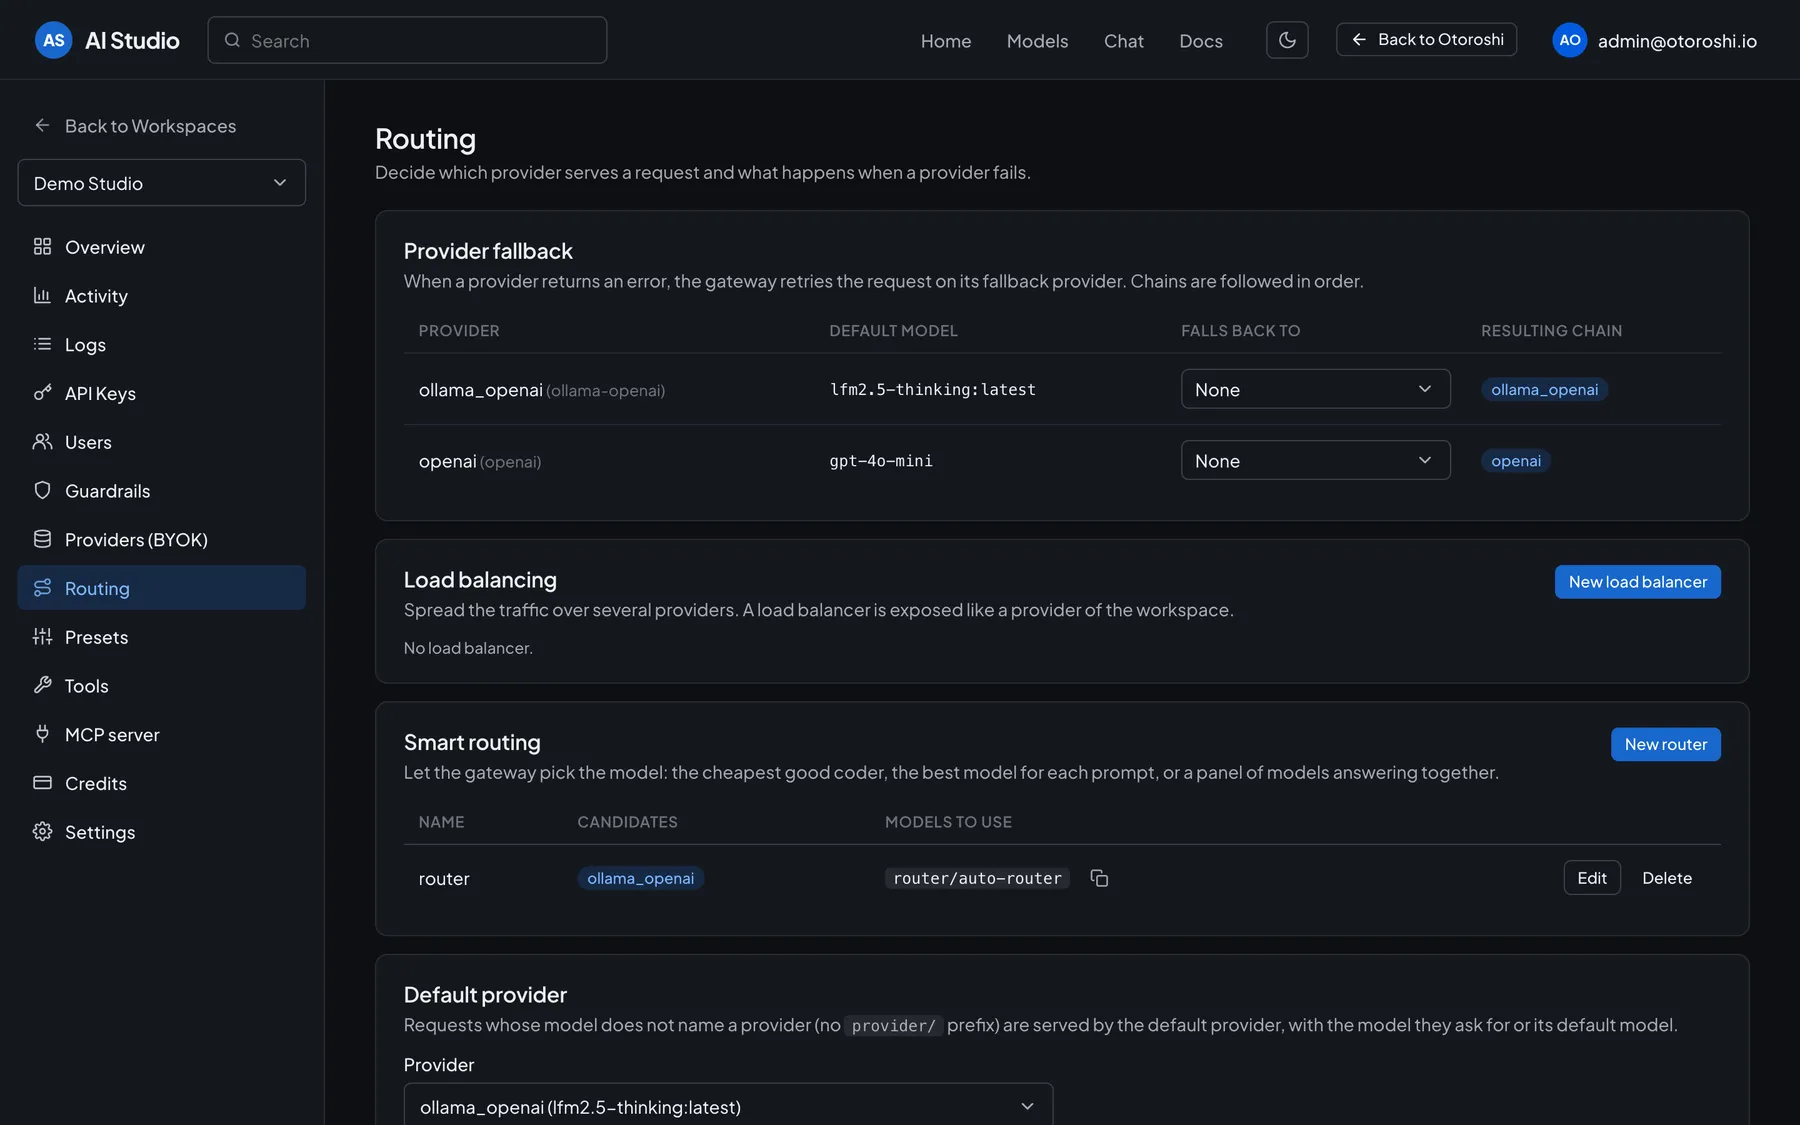
Décidez quel fournisseur sert une requête et ce qui se passe quand il échoue : chaînes de repli, load balancers exposés comme un fournisseur, routage intelligent qui choisit le meilleur codeur au meilleur prix ou le meilleur modèle pour chaque prompt. Puis restreignez les modèles d’un workspace, appliquez des politiques de contenu aux prompts et aux réponses, et plafonnez les dépenses, pour chaque clé.
- Chaînes de repli entre fournisseurs
- Load balancing & routage intelligent
- Modèles autorisés et bloqués
- Politiques de contenu
Au-delà du chat
Tout ce qu’il faut pour
l’IA en production.
Chat & playground
Chattez avec n’importe quel modèle du workspace, comparez les réponses côte à côte, et essayez vos serveurs MCP dans un playground.
Prompts & contextes
Templates de prompts, contextes et presets, gérés de façon centralisée plutôt que codés en dur dans chaque application.
MCP & agents
Connecteurs MCP, serveurs MCP virtuels, tool calling, workflows et agents IA, tous gouvernés par la gateway.
Multimodal
Audio (text-to-speech, speech-to-text), images, embeddings et vector stores derrière la même gateway.
Cache sémantique
Servez les prompts similaires depuis le cache : moins d’appels aux modèles, des réponses plus rapides, des factures plus légères.
Coût & CO₂ par appel
Connaissez le prix et l’impact écologique de chaque requête, par modèle, fournisseur ou consommateur.
À votre façon
Managé, serverless
ou auto-hébergé.
Sur Otoroshi Managed
L’extension LLM et AI Studio sont inclus dans chaque offre managée, avec toutes les fonctionnalités d’Otoroshi.
DécouvrirSur Serverless
Les plugins IA sont intégrés, sans configuration. Démarrez avec le starter de projet IA.
DécouvrirSur votre Otoroshi
L’extension LLM et AI Studio sont open source (Apache 2.0). Installez-les sur vos propres clusters.
DécouvrirAI Studio Enterprise
AI Studio pour toute votre organisation : login d’entreprise, rôles dans chaque workspace, journal d’audit.
DécouvrirFAQ
Questions fréquentes
Une autre question ? Parlez-en à notre équipe.
Qu’est-ce qu’AI Studio ?
AI Studio est la console de l’AI gateway. Vos équipes y obtiennent des clés d’API, parcourent les modèles des fournisseurs connectés, chattent avec eux et suivent leur consommation et leurs dépenses ; les administrateurs y règlent fournisseurs, routage, guardrails et budgets. Il fait partie de l’extension LLM d’Otoroshi, open source, et AI Studio Enterprise l’ouvre à toute votre organisation.
Qu’est-ce qu’une AI gateway ?
Une AI gateway est similaire à une API gateway, mais conçue pour le trafic IA. Elle gère, route et sécurise les appels aux LLM et aux autres services d’IA, pour intégrer l’IA dans vos applications de manière fiable et à grande échelle.
Quels fournisseurs d’IA puis-je utiliser ?
Plus de 50 fournisseurs via une seule API compatible OpenAI, dont OpenAI, Azure OpenAI, Anthropic, Mistral, Gemini, Groq, DeepSeek, Scaleway, OVHcloud AI Endpoints, Cohere, Hugging Face, Cloudflare AI, ainsi que des modèles locaux avec Ollama.
Où puis-je utiliser l’AI Gateway ?
Les fonctionnalités IA sont intégrées à la fois à Otoroshi Managed (l’extension LLM est incluse dans chaque offre) et à Serverless. L’extension LLM étant open source, vous pouvez aussi la faire tourner sur votre propre Otoroshi.
Puis-je router le trafic vers différents LLM ?
Absolument. Chaînez des fallbacks quand un fournisseur échoue, répartissez le trafic entre plusieurs fournisseurs avec un load balancer, ou laissez le routage intelligent choisir le modèle, comme le meilleur codeur au meilleur prix ou le meilleur modèle pour chaque prompt.
Comment le cache sémantique réduit-il les coûts de l’IA ?
Le cache sémantique identifie les prompts similaires et renvoie des réponses déjà stockées au lieu d’appeler à nouveau le modèle. Il réduit considérablement le nombre d’appels coûteux aux modèles et améliore les temps de réponse.
Puis-je définir des budgets par clé d’API ou par équipe ?
Oui. Les budgets sont des plafonds de dépenses appliqués par la gateway, par clé d’API ou pour tout un workspace, chacun sur sa propre fenêtre. Des quotas peuvent aussi être définis par clé.
Puis-je suivre les coûts des LLM ?
Oui. Le suivi des coûts est activé par défaut. La page Activity d’AI Studio montre les dépenses par clé d’API, par utilisateur et par modèle, avec les tendances, et les exporte en CSV.
Puis-je protéger mes prompts et mes données ?
Oui. Les guardrails détectent et bloquent les données personnelles (PII), les fuites de secrets, les injections de prompt ou les contenus toxiques dans les requêtes et les réponses, avant que quoi que ce soit n’atteigne le modèle ou vos utilisateurs.
Prêt à construire ?Démarrez en quelques minutes.
Lancez gratuitement un cluster Otoroshi managé ou un projet serverless, ou demandez-nous une démo live de toute la plateforme.